2. 빅테크와 AI 스타트업의 포지션
2-1. 인프라 레이어: 빅테크 독점
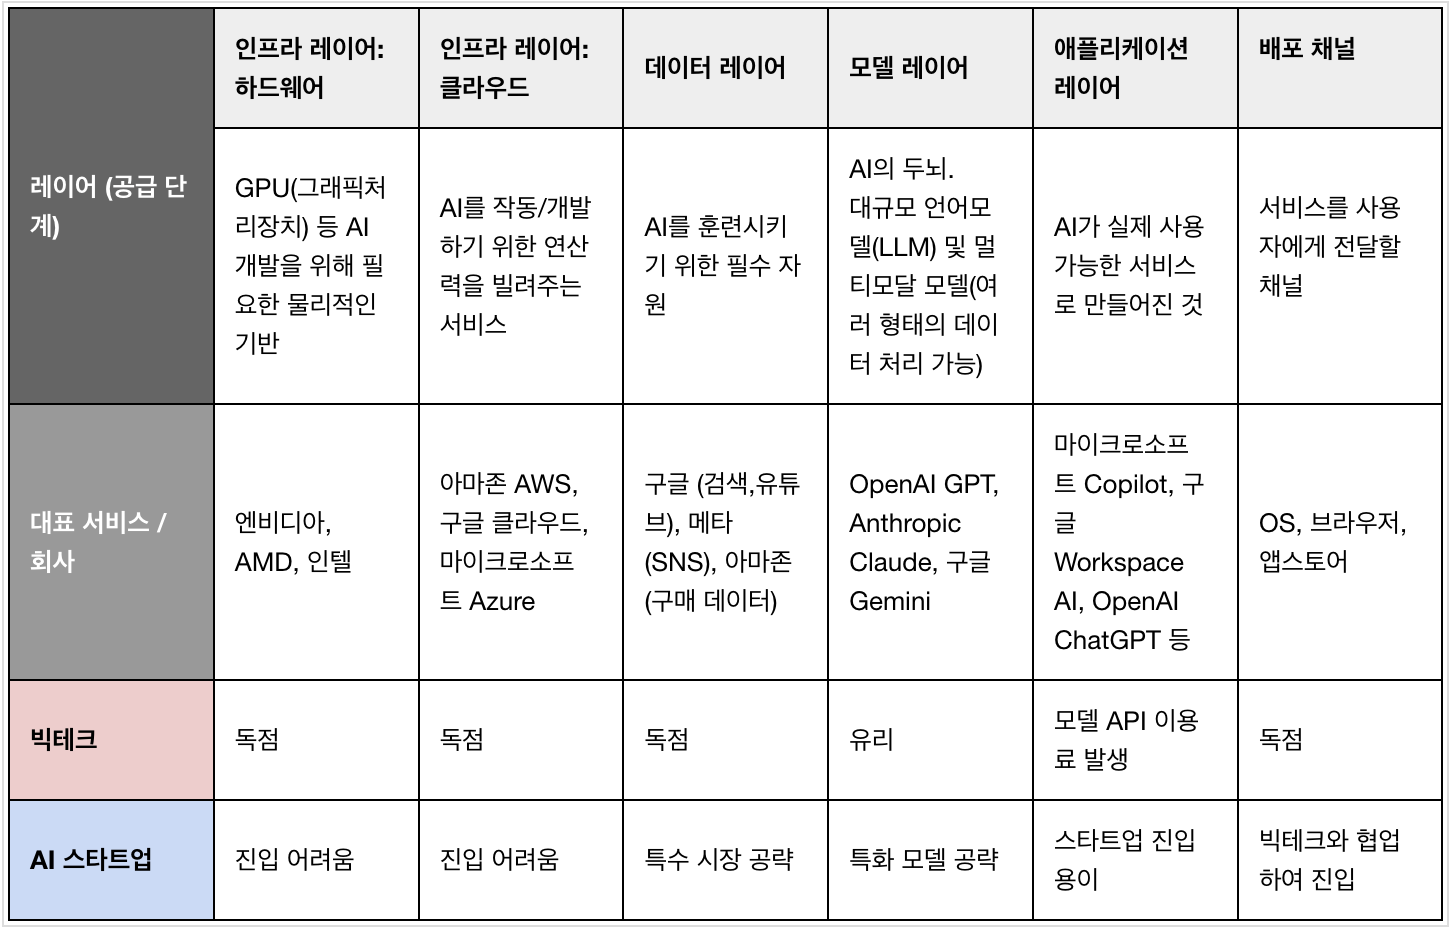
구글, 마이크로소프트, 아마존은 AI 학습과 배포에 필요한 하드웨어와 장치를 확보하며 사실상 인프라를 독점하고 있다.
중소형 스타트업은 자체적으로 이를 마련하기 어렵기 때문에 빅테크의 클라우드를 이용한다.
초기 개발 단계에서는 전체 운영 비용의 60% 이상을 클라우드 이용료로 지출할 정도로, 빅테크에는 돈이 되는 사업이다.
2-2. 데이터 레이어: 빅테크 유리, 스타트업은 특화
데이터는 AI 모델 학습에 필수적인 자원으로, AI의 성능을 결정할 정도로 중요하다.
구글은 검색, 메타는 SNS, 아마존은 구매 데이터를 이미 확보해 성능 개발에서 우위를 점한다.
스타트업은 이러한 거대 데이터에 접근하기 어렵기 때문에, 특수한 영역의 데이터를 활용해 틈새 모델을 개발한다.
(ex. 서비스 사용자 데이터 기반으로 개발한 Notion AI, 오픈뱅킹/금융 데이터를 기반으로 한 핀테크 모델)
이런 특화 모델은 빅테크가 제공하지 못하는 영역에서 차별화된 경쟁력을 갖는다.
2-3. 모델 레이어: 빅테크 우위, 스타트업 기회 확대
AI 모델의 학습을 위해서는 방대한 데이터와 전력량이 필요하며,
이미 클라우드와 데이터를 확보한 빅테크가 유리하다.
그러나 최근 두 가지 흐름이 생기면서 스타트업에게도 기회가 생기고 있다.
첫째, 특화 AI 수요 증가다.
의료, 금융, 법률, 로컬 언어 등 특정 분야에서는 거대 모델보다 분야별 전문 모델이 더 효율적이다.
둘째, 일부 빅테크의 무료 모델 배포다.
메타 Llama나 구글 Gemma는 스타트업이 필요한 기본 AI 성능을 무료로 제공함으로써
GPT와 같은 폐쇄형 모델에 맞서 경쟁력을 갖추고자 한다.
스타트업은 이를 활용해 자체 특화 모델을 저렴하고 빠르게 개발할 수 있다.
이로써 스타트업은 작은 규모에서도 경쟁력 있는 모델을 만들고, AI 서비스 시장에 진입할 수 있다.
2-4. 애플리케이션 레이어: 스타트업 진입 용이
AI를 활용해 서비스를 제공하는 것은 스타트업이 빠르게 시장에 진입할 수 있는 영역이다.
직접 모델을 개발하지 않아도 빅테크의 모델(API)을 활용하면 새로운 서비스를 개발할 수 있기 때문이다.
다만 API 비용이 전체 비용의 30~60%까지도 차지할 수 있어,
전략 없이 단순 활용만으로는 장기 수익 확보가 어렵다.
따라서 애플리케이션 레이어는 스타트업에게 진입 장벽은 낮지만, 지속적인 수익화 전략이 필수적이다.
|